
Implementatie van generatieve AI in de zorg: uitdagingen en kwaliteitsborging
Over eerste ervaringen, ontbrekende kwaliteitsstandaarden en de vraag wanneer GenAI in de zorg ‘goed genoeg’ is
Door Kim J.M. Bladder1; Dani P. Reuvekamp2; Arjen P. de Vries, Prof, PhD3; Tim Frenzel, MD, PhD4; Julie E.M. Swillens5, PhD
Generatieve AI (GenAI) verovert in hoog tempo de zorg, met als doel betere zorg tegen minder werkdruk. Het belooft de zorgkwaliteit en het werkplezier te verbeteren en tegelijkertijd de administratieve lasten voor zorgverleners te verlagen. De implementatie van deze technologie brengt echter ook nieuwe uitdagingen op het gebied van betrouwbaarheid, veiligheid en kwaliteitsbewaking. Hoe bepaal je de kwaliteit van GenAI? Wanneer draagt de inzet van GenAI daadwerkelijk bij aan de patiëntenzorg? In dit artikel beschrijven we een implementatiestudie in het Radboudumc van een GenAI-toepassing binnen het elektronisch patiëntendossier. We verkennen ook de vraag hoe we de kwaliteit van GenAI in de zorg kunnen beoordelen.
Artificiële Intelligentie (AI) in de zorg omvat verschillende typen toepassingen, waaronder diagnostische of predictiemodellen en generatieve AI (GenAI). Diagnostische en predictiemodellen analyseren bestaande data om bijvoorbeeld diagnoses te ondersteunen of risico’s te voorspellen. GenAI daarentegen creëert nieuwe content, zoals tekst of samenvattingen. GenAI ontwikkelt zich snel en wordt onder meer ingezet om klinische documentatie te ondersteunen, bijvoorbeeld door consulten in de spreekkamer automatisch vast te leggen, te transcriberen en te structureren. Het doel is minder tijd te besteden aan repetitieve taken en minder fouten te maken bij de overdracht tussen zorgverleners. Deze beloftes sluiten aan bij beleidsambities uit het Integraal Zorgakkoord (IZA) en het Aanvullend Zorg en Welzijnsakkoord (AZWA), waarin wordt ingezet op het verlagen van de administratieve lasten tot maximaal 20% administratietijd voor zorgverleners in 2030 (VWS, 2022; VWS, 2025). AI wordt hierin expliciet genoemd als een oplossing om administratielast te verlagen. Bij huidige AI-tools is nog onduidelijk wat de meerwaarde precies is, voor wie in de zorg die geldt en wat er nodig is om die te realiseren. Daarom is het belangrijk om de ervaren effectiviteit, de haalbaarheid en de knelpunten van de implementatie van AI-tools te onderzoeken.
GenAI implementeren in de klinische praktijk van zorgverleners
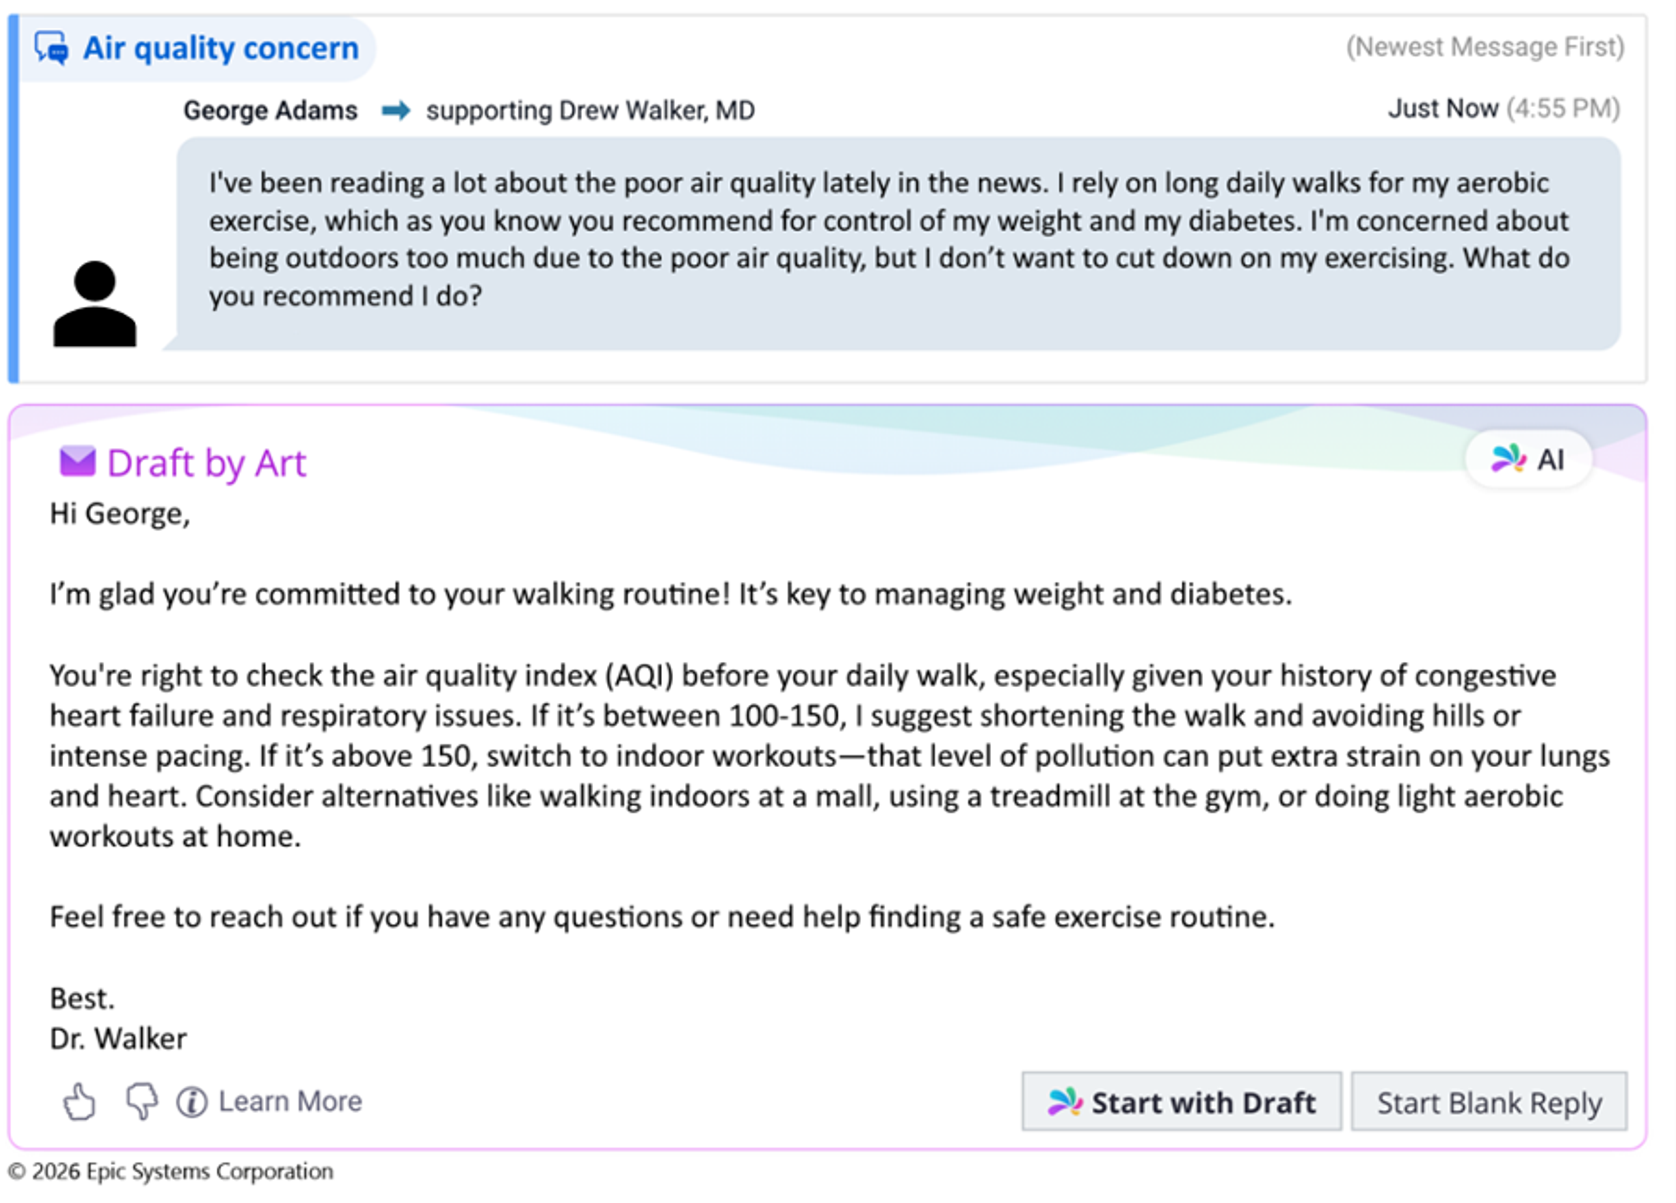
Sinds oktober 2024 is de eerste GenAI-toepassing, Art, geactiveerd binnen het elektronisch patiëntendossier (EPD) in het Radboudumc. De implementatie van deze toepassing bood een gelegenheid om de inzet van GenAI in de klinische praktijk systematisch te evalueren. Art is een GenAI-toepassing van Epic (Epic Systems Corporation, Verona, WI, USA) die automatisch conceptantwoorden genereert op vragen van patiënten die binnenkomen via het In Basket-berichtensysteem, het beveiligde, op berichten gebaseerde takensysteem van Epic binnen het EPD waarin zorgverleners patiëntberichten, labuitslagen, herhaalrecepten en onderling overleg ontvangen en afhandelen. Een voorbeeld van de schermweergave van Art is weergegeven in Afbeelding 1. In de periode januari – juni 2025 kregen 237 zorgverleners van vier afdelingen (dermatologie, keel-, neus- en oorheelkunde (KNO), medische oncologie en longziekten) toegang tot Art.
Evaluatiestudie
We hebben een evaluatiestudie uitgevoerd van de implementatie van Art op vier afdelingen van het Radboudumc, waarbij we keken naar adoptie, effect, haalbaarheid en implementatiefactoren (Bladder et al., 2026). Hiervoor werden twee online vragenlijsten met gesloten en open vragen uitgezet onder bijna 150 eindgebruikers (artsen, verpleegkundigen, A(N)IOS, verpleegkundige specialisten, physician assistants, doktersassistentes) om verwachtingen en ervaringen met de toepassing te inventariseren en werd gebruikersdata uit Epic verzameld. Dit aantal was lager dan de gehele groep die toegang had, omdat niet iedereen beschikbaar was tijdens de onderzoeksperiode om de vragenlijst in te vullen. Adoptie werd geëvalueerd op basis van data uit de vragenlijst over gebruik van Art en data uit Epic over gebruik, gebruiksfrequentie en hoeveelheid feedback. Effect werd geëvalueerd door data uit de vragenlijsten over ervaren welzijn en ervaren klinische effectiviteit, aangevuld met efficiëntiematen, berekend aan de hand van data uit Epic, waaronder de tijd die een zorgverlener nodig heeft om een bericht te lezen en te verzenden. Haalbaarheid werd geëvalueerd op basis van data uit de vragenlijsten over gebruiksvriendelijkheid. Knelpunten en bevorderende factoren voor implementatie werden opgehaald via de vragenlijsten en kwalitatief geanalyseerd met behulp van het NASSS framework (Greenhalgh et al., 2017).
Evaluatiestudie laat gemixte resultaten zien
Tussen januari en juni 2025 werden in totaal 8.410 conceptantwoorden gegenereerd met Art. De adoptie van Art was eerst hoog, maar daalde geleidelijk. Het ervaren welzijn van zorgverleners bleef stabiel gedurende de studieperiode. De ervaren klinische effectiviteit rondom het beantwoorden van vragen van patiënten via het systeem met behulp van Art was significant lager dan de verwachte effectiviteit. De ervaren gebruiksvriendelijkheid was ook significant lager dan de verwachting hiervan. Zorgverleners benoemden bevorderende factoren, zoals verwachte tijdsbesparing, de duidelijke structuur van de conceptantwoorden en het gebruik van patiëntgerichte taal. Tegelijkertijd werden verschillende knelpunten ervaren, waaronder beperkte aansluiting op de workflow, geen ervaren tijdbesparing, inhoudelijke onnauwkeurigheden en stijlverschillen tussen AI‑gegenereerde antwoorden en persoonlijke communicatievoorkeuren. Beperkte ervaring met de tool, onvoldoende ondersteuning en zorgen over de betrouwbaarheid van de output, kwamen ook naar voren in onze studie als knelpunten voor implementatie.
Implementatie-uitdagingen: verwachtingen en vertrouwen als bepalende factoren
Deze evaluatie van de implementatie van Art laat een kritisch beeld zien, waarbij de ervaringen achterbleven bij de verwachtingen. De verschillende percepties onder zorgverleners over de ervaren effecten van Art, ook gevonden in de studie van Garcia et al. (2024), lijken deels voort te komen uit uiteenlopende verwachtingen. Waar de ene zorgverlener een vrijwel compleet en medisch correct antwoord verwachtte, zag de ander het Art-bericht vooral als een eerste opzet die cognitieve belasting kan verminderen, maar waarbij altijd medische beoordeling vereist is. Naast deze verschillen in verwachtingen gaven de deelnemers ook aan bezorgd te zijn over de betrouwbaarheid van de tool, bijvoorbeeld door inhoudelijke onnauwkeurigheden. Deze zorgen ondermijnen het vertrouwen in de tool, wat cruciaal is voor de ervaren kwaliteit en uiteindelijke implementatie. Dat vertrouwen blijkt ook geen vanzelfsprekendheid. Door het black-box karakter van GenAI-toepassingen is het voor zorgverleners vaak onduidelijk hoe een antwoord tot stand komt, wat de transparantie en voorspelbaarheid van de tool beperkt. Vertrouwen wordt daardoor afhankelijk van factoren zoals consistentie, accuraatheid en voorspelbaarheid van de output (Hassan et al., 2022). Ook in andere studies komen zorgen over de betrouwbaarheid en de daarmee gepaard gaande verantwoordelijkheid van zorgverleners terug als knelpunt (Faric et al., 2023; Swillens et al., 2023). Dit laat zien dat er meer nodig is dan alleen de “human in the loop” als bescherming tegen fouten. Het benadrukt ook dat het essentieel is om, in lijn met artikel 4 van de EU-AI-verordening (EU, 2024), het doel en de functionaliteit van de GenAI-tool goed te communiceren, de klinische verantwoordelijkheid expliciet vast te leggen en te voorzien in voortdurend toezicht en monitoring.
Naar een antwoord op de vraag: Wanneer is GenAI ‘goed genoeg’?
De centrale vraag die uit deze implementatiestudie naar voren komt is wanneer een GenAI-toepassing, zoals Art, voldoende kwaliteit levert voor opschaling. Dat roept de vraag op of de indicatoren die we tot nu toe gebruiken wel de juiste zijn om die kwaliteit te bepalen. In onze evaluatiestudie lag de nadruk op daadwerkelijk gebruik, ervaren klinische effectiviteit, welzijn en gebruikservaringen, aangevuld met objectieve maatstaven zoals gebruiksfrequentie en tijdsindicatoren. Deze indicatoren zijn waardevol, maar dekken mogelijk niet alle relevante kwaliteitsdimensies, zoals veiligheid, effectiviteit, efficiëntie, tijdigheid, patiëntgerichtheid en toegankelijkheid.
Daarnaast laten de gemixte percepties onder zorgverleners zien dat 'goed genoeg' geen eenduidig begrip is en kan verschillen per gebruiker, afdeling of use case. Dit roept nieuwe vragen op. Accepteren we dat een toepassing voor sommige zorgverleners meerwaarde biedt en voor anderen niet? En zo ja, welke drempels hanteren we dan voor besluitvorming over implementatie en opschaling?
Zolang gestandaardiseerde evaluatiekaders ontbreken, zijn studies onderling moeilijk te vergelijken, wat het lastig maakt om minimale kwaliteitseisen voor AI-implementatie vast te stellen. Consensus vormen onder zorgverleners is daarom een noodzakelijk vervolg: Welke uitkomstmaten zijn relevant? Hoe kun je die meten? En welke drempelwaarde kun je hanteren? Op dit moment lopen er diverse initiatieven om deze vragen (deels) te beantwoorden zoals het internationale GENAISIS project (UMC Utrecht, 2026) en het landelijke ZonMw RIGH:T project (ZonMw, 2025).
Conclusie
Deze implementatiestudie naar de invoering van Art laat zien dat de kwaliteit en meerwaarde van GenAI-toepassingen zoals Art sterk persoons- en contextafhankelijk zijn, terwijl besluitvorming over opschaling juist om generieke, gedeelde criteria vraagt. De gevonden knelpunten (waaronder zorgen over de betrouwbaarheid van de output) en het ontbreken van gedeelde kwaliteitsindicatoren laten zien dat GenAI niet alleen een technologische innovatie is, maar vooral een organisatorische uitdaging. Zolang niet duidelijk is welke drempelwaarden bepalen of een toepassing 'goed genoeg' is, stagneert de besluitvorming van ziekenhuizen over implementatie en opschaling, ook wanneer individuele zorgverleners al wel meerwaarde ervaren. Onze studie benadrukt daarom het belang van vroegtijdig in kaart brengen van kwaliteitspercepties en implementatiefactoren. Dat vraagt om landelijke of zelfs internationale consensus over welke kwaliteitsindicatoren en minimale eisen per use case gelden, maar ook om implementatiegericht onderzoek naar wat werkt, voor wie en in welke omgeving. Alleen door deze individuele verschillen te erkennen en te werken aan gedeelde criteria kan GenAI verantwoord worden geïntegreerd in de klinische praktijk.
Bronnen
- Ministerie van Volksgezondheid, Welzijn en Sport. Integraal Zorgakkoord. 2022. Geraadpleegd 10 september 2026, op: file:///C:/Users/z820211/Downloads/integraal-zorg-akkoord.pdf
- Ministerie van Volksgezondheid, Welzijn en Sport. Aanvullend Zorg- en Welzijnsakkoord. 2025. Geraadpleegd 10 september 2026, op: https://open.overheid.nl/documenten/52fcdec1-71d5-4695-87bf-e4c46c73d730/file
- Bladder, K.J.M., et al. AI-Generated Responses to Patient's Messages: Effectiveness, Feasibility and Implementation. Preprint. MedArxiv. Accepted in JMIR AI.
- Greenhalgh, T., et al. Beyond adoption: a new framework for theorizing and evaluating nonadoption, abandonment, and challenges to the scale-up, spread, and sustainability of health and care technologies. Journal of medical Internet research, 19.11 (2017): e8775.
- Garcia P, Ma SP, Shah S, et al. Artificial Intelligence–Generated Draft Replies to Patient Inbox Messages. JAMA Netw Open. 2024;7(3):e243201.
- Hassan, N., Slight, R., & Slight, S. 7 Healthcare staff perceptions on Using Artificial Intelligence Predictive Tools: A qualitative study. BMJ Journal, A4.2-A5 (2022).
- Faric N, Hinder S, Williams R, et al. Early experiences of integrating an artificial intelligece-based diagnostic decision support system into radiology settings: a qualitative study. J Am Med Inform Assoc. 2023;31(1):24-34.
- Swillens JEM, Nagtegaal ID, Engels S, Lugli A, Hermens RPMG, Van Der Laak JAWM. Pathologists’ first opinions on barriers and facilitators of computational pathology adoption in oncological pathology: an international study. Oncogene. 2023;42(38):2816-2827.
- Regulation (EU) 2024/1689 of the European Parliament and of the Council of 13 June 2024 (Artificial Intelligence Act). 2024:1-144. Geraadpleegd 25 augustus, 2026. https://eur-lex.europa.eu/legal-content/EN/TXT/?uri=CELEX:32024R1689
- UMC Utrecht. Richtlijn voor Generatieve AI in de gezondheidszorg (GENAISIS). (2026). Geraadpleegd op 14 oktober, 2026. Guideline AI healthcare
- ZonMw. RIGH:T: ontwikkeling van een validatieframework voor generatieve AI-systemen in de zorg. (2025). Geraadpleegd 14 oktober, 2026. RIGH:T: ontwikkeling van een validatieframework voor generatieve
1Junior onderzoeker bij IQ Health Science Department, Radboudumc Nijmegen
2Bachelor student Communicatiewetenschappen, Radboud Universiteit Nijmegen
3Hoogleraar data science bij Institute for Computing and Information Sciences, Radboud Universiteit Nijmegen
4Medical information officer (MIO) & Intensivist bij Afdeling Intensive Care, Radboudumc Nijmegen
5Assistant professor Implementation Science bij IQ Health Science Department, Radboudumc Nijmegen